Dimensionamiento de hardware
Seleccionamos la configuración según modelo, memoria y carga prevista.
 NVYON
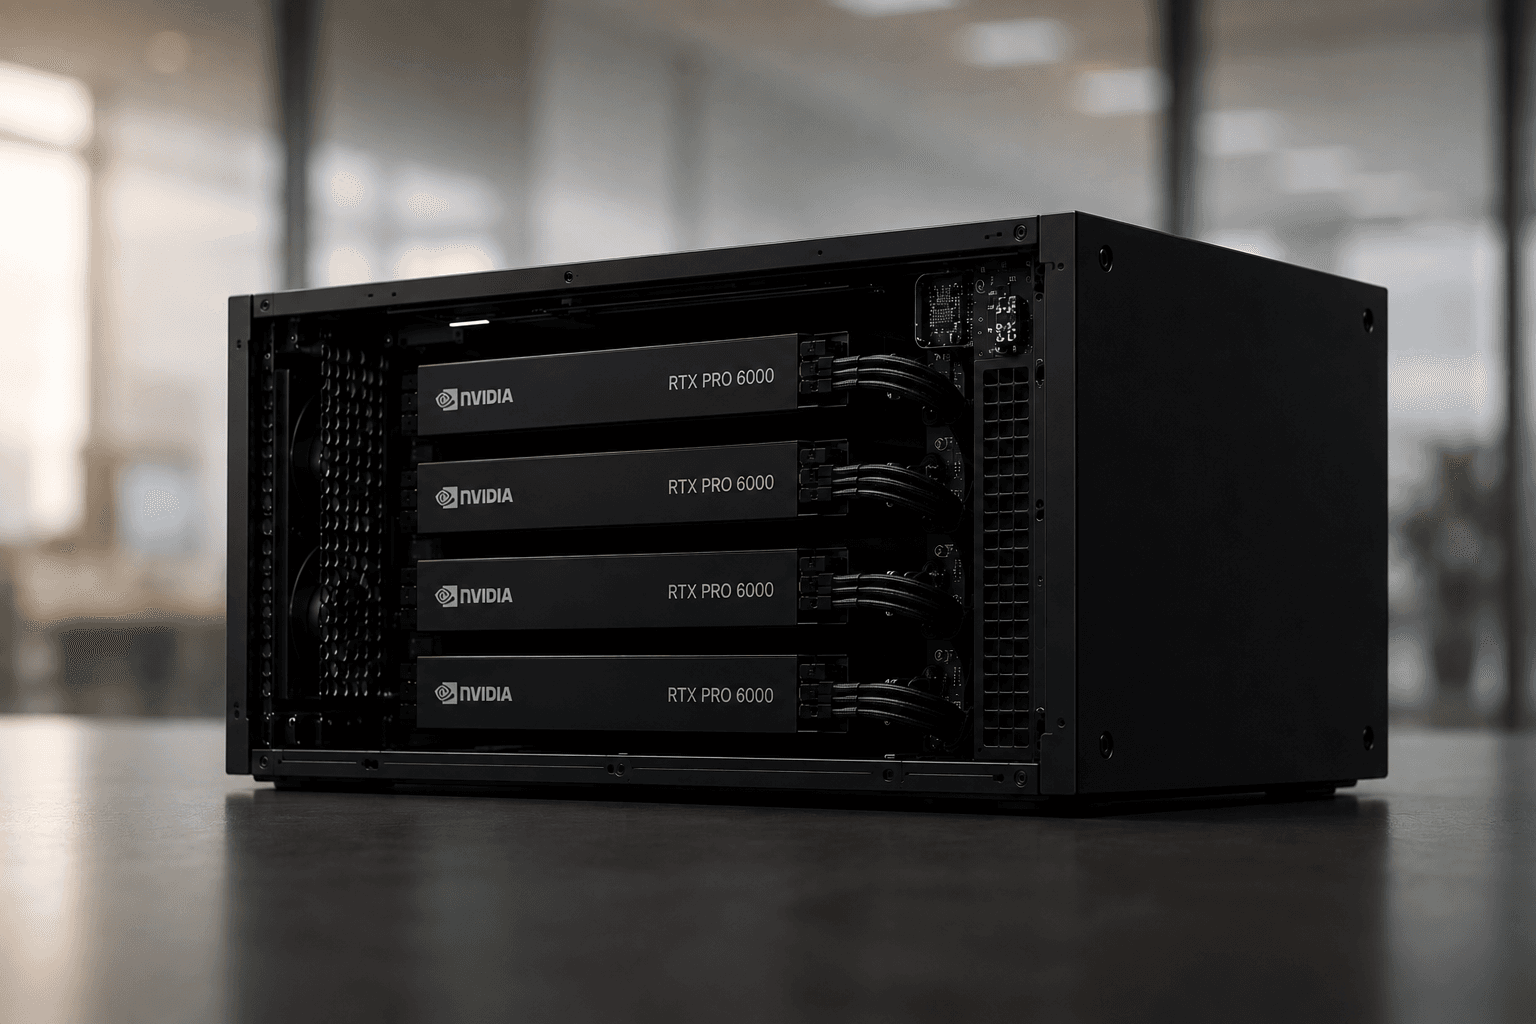
Ejecuta modelos y servicios de inteligencia artificial sobre una infraestructura dedicada, conectada con tus sistemas y bajo el control técnico de tu organización.
Una arquitectura de IA on-premise ejecuta los modelos y servicios de inferencia en las instalaciones de la organización. La propiedad del hardware y quién lo administra son decisiones adicionales a su ubicación.
Las instalaciones pueden incluir un centro de datos de la organización. Si el nodo se aloja en un proveedor externo, hablamos de alojamiento dedicado externo. En ambas modalidades hay que definir quién administra la infraestructura, cómo se accede y por dónde circulan datos, registros y copias.
Esta forma de despliegue puede integrarse en una estrategia más amplia deIA privada para empresas, centrada también en permisos, información y procesos internos.
Sobre esa arquitectura puedeejecutarse un LLM local, mientras que la capacidad disponible se define medianteservidores de IAdimensionados para la carga real.
Cuando el servicio principal es un modelo de lenguaje, el despliegue específico deun LLM on-premisecombina modelo, motor y API privada. La decisión de propiedad y operación se desarrolla también en la guía dehardware de IA para empresas.
La propuesta concreta qué componentes se entregan y qué servicios se contratan para tu proyecto. El alcance puede variar según la carga, las instalaciones y las integraciones.
Seleccionamos la configuración según modelo, memoria y carga prevista.
Ajustamos el modelo a las tareas, el contexto y los recursos disponibles.
Preparamos el software que carga el modelo y procesa las peticiones.
Definimos el acceso de las aplicaciones a la inferencia y las funciones incluidas en el proyecto.
Configuramos cómo se identifican los usuarios y aplicaciones y qué accesos tienen.
Definimos qué señales del servicio se supervisan y quién atiende los eventos según el alcance contratado.
Se prestan cuando forman parte de la propuesta, con responsabilidades definidas en el acuerdo.
Acordamos las fuentes, aplicaciones y conexiones incluidas; no se presupone un catálogo de integraciones terminadas.
El número de empleados ayuda a estimar el uso, pero no determina por sí solo la capacidad. Revisamos el modelo, las peticiones y los objetivos del servicio antes de elegir hardware; la validación contrasta la configuración con una carga representativa.
Un despliegue dedicado u on-premise puede resultar desproporcionado para uso esporádico, pruebas breves o cargas pequeñas que ya resuelve un servicio aprobado. También conviene posponerlo si no hay instalaciones adecuadas ni responsables de operación. Una necesidad de alta disponibilidad puede aumentar la infraestructura y el coste; debe evaluarse, no darse por incluida.
Revisar la guía de implementación y validaciónModelo: tamaño, formato y configuración que requiere la tarea.
VRAM: memoria de GPU para pesos, contexto y peticiones activas.
Contexto: longitud de instrucciones y documentos por consulta.
Concurrencia: peticiones simultáneas y picos, no solo usuarios registrados.
Tokens de salida: cuánto debe generar el modelo en cada respuesta.
Latencia: espera aceptable hasta el primer token y la respuesta completa.
Horario y carga: uso continuo, ventanas de trabajo y procesos por lotes.
Disponibilidad requerida: continuidad y recuperación que necesita el cliente, para definir la arquitectura y presupuestarla.
El acceso se protege, el servidor procesa la petición y el modelo utiliza solo las fuentes e integraciones autorizadas para devolver una respuesta.
Usuarios y aplicaciones
Identidad y permisos
Infraestructura dedicada
Motor de inferencia
Datos y herramientas
La solución se diseña alrededor del trabajo que debe realizar, sin asociar de antemano el proyecto a un modelo o una configuración de hardware concretos.
Generación, análisis y transformación de texto mediante inferencia local.
Acceso conversacional al conocimiento y la documentación autorizada.
Flujos que consultan herramientas y ejecutan acciones dentro de reglas definidas.
Clasificación, extracción, resumen y búsqueda sobre contenido empresarial.
Capacidades de IA disponibles para aplicaciones y automatizaciones internas.
Procesamiento combinado de formatos cuando el modelo y la infraestructura lo permitan.
No son opciones universalmente mejores o peores. La elección depende del control, la integración y el patrón de uso que necesita cada empresa.
La IA en servidores propios o dedicados suele evaluarse cuando la organización quiere acercar el modelo a su información y disponer de mayor control técnico.
Evaluar mi caso con EnvyonInformación empresarial sensible o documentación interna.
Conocimiento corporativo que debe conectarse al modelo.
Integraciones profundas con aplicaciones y sistemas internos.
Necesidad de infraestructura dedicada y accesos propios.
Cargas recurrentes de inferencia para equipos o aplicaciones.
Organizaciones que buscan mayor independencia técnica.
Primero entendemos la necesidad y la carga. Después definimos el modelo, la infraestructura y la operación que necesita el sistema.
Definimos usuarios, información, objetivos e integración según proyecto.
Valoramos modelo, contexto, concurrencia y requisitos de las instalaciones.
Configuramos los modelos, el acceso privado y las conexiones acordadas.
Comprobamos las tareas y los criterios acordados antes de poner el sistema en servicio.
Habilitamos el uso en las instalaciones y dentro del alcance definido.
Monitorización, soporte y mantenimiento cuando estén contratados.
Significa que los modelos y servicios de inteligencia artificial se ejecutan en las instalaciones de la organización. El alojamiento dedicado externo es otra modalidad de ubicación. En ambas, la operación puede ser propia o gestionada según el acuerdo.
IA privada describe principalmente el nivel de control sobre los datos, los accesos y la solución. IA on-premise describe su ubicación en las instalaciones de la organización. Dedicado describe recursos reservados; la operación propia o gestionada indica quién los administra. Una arquitectura on-premise puede formar parte de una estrategia de IA privada, pero los conceptos no son idénticos.
Sí. Los modelos de lenguaje pueden ejecutarse en servidores o nodos de IA preparados para inferencia local. La elección del modelo y de la infraestructura depende del caso de uso, el volumen de consultas, el contexto procesado y los usuarios previstos.
Depende de la arquitectura. La inferencia puede funcionar dentro de la red privada, pero las actualizaciones, determinadas integraciones o la administración remota pueden requerir conectividad. Envyon define estos accesos según las necesidades y restricciones del proyecto.
Necesita un caso de uso definido, fuentes de datos identificadas, una política de acceso y una infraestructura dimensionada para la carga prevista. También hay que preparar el modelo, el motor de inferencia, las integraciones y la operación del sistema.
Sí. En la modalidad gestionada, Envyon proporciona y mantiene la infraestructura dedicada según el acuerdo contratado. La empresa también puede adquirir el hardware en propiedad y encargar a Envyon la preparación del entorno.
Cuéntanos qué sistemas quieres conectar, quién utilizará los modelos y qué nivel de control necesita tu organización.